Fish Audio S2.1 Pro: واجهة برمجة تطبيقات (API) مجانية لتحويل النص إلى كلام للمطورين


ملخص سريع:
S2.1 Pro، نموذج الصوت الأكثر تقدماً من Fish Audio، متاح الآن كواجهة برمجة تطبيقات (API) مجانية لتحويل النص إلى كلام.
83 لغة، استخدام غير محدود بموجب سياسة الاستخدام العادل.
سلسلة النموذج (Model string): s2.1-pro-free — أضفها ببساطة إلى استدعاءات Fish API الحالية الخاصة بك.
جرب S2.1 Pro مجاناً — أول مقطع صوتي خلال 5 دقائق ←
يونيو 2026 | نموذج S2.1 Pro من Fish Audio متاح الآن كواجهة برمجة تطبيقات مجانية لتحويل النص إلى كلام مع وصول غير محدود بموجب سياسة الاستخدام العادل.
لماذا كان الذكاء الاصطناعي الصوتي عالي الجودة مكلفاً دائماً؟
إذا قضيت أي وقت في تقييم واجهات برمجة تطبيقات تحويل النص إلى كلام (TTS APIs)، فأنت تعرف النمط بالفعل: النماذج التي تبدو جيدة حقاً تكلف مالاً.
المستوى المجاني لـ ElevenLabs يمنحك 10,000 رصيد شهرياً (حوالي 6 - 10 دقائق) قبل أن تبدأ المطالبة بالدفع. أما OpenAI TTS فيعتمد على الدفع مقابل الاستخدام مع عدم وجود مستوى مجاني على الإطلاق. وأحدث نماذج Gemini TTS من Google — وهي الأكثر تقدماً لديهم — ليس لديها استخدام مجاني: أنت تدفع منذ أول رمز (token). هذا النمط متسق عبر الصناعة: جودة الصوت المتطورة كانت دائماً ميزة مدفوعة.
هذا يخلق مشكلة حقيقية للمطورين. سوق مولدات الصوت بالذكاء الاصطناعي ينمو بنسبة 20% سنوياً تقريباً — لكن الأدوات المخصصة لبناء منتجات تدعم الصوت ظلت وراء جدران الدفع. لا يمكنك تقييم نموذج بشكل صحيح بـ 10,000 رصيد فقط. ولا يمكنك بناء نموذج أولي لعميل صوتي، أو اختبار خط معالجة للكتب الصوتية، أو تجربة استنساخ الصوت دون الالتزام بميزانية مقدمة أو قضاء أسابيع في التعامل مع البدائل مفتوحة المصدر التي تتطلب بنية تحتية خاصة بك من وحدات معالجة الرسومات (GPU).
Fish Audio تغير ذلك اليوم.
ما هو S2.1 Pro؟

S2.1 Pro هو نموذج الصوت المتطور الحالي من Fish Audio — أفضل نموذج لدينا، وهو متاح الآن لكل مطور مجاناً عبر API. إنه نموذج عصبي لتركيب الكلام مصمم لإنشاء أصوات ذكاء اصطناعي بجودة إنتاجية احترافية، مع نقاط قوة خاصة في البث منخفض زمن الوصول، وتحويل النص إلى كلام متعدد اللغات، واستنساخ الصوت. إنه يعتمد على أساس S2، الذي أصدرناه بأوزان مفتوحة في وقت سابق من هذا العام.
الأداء
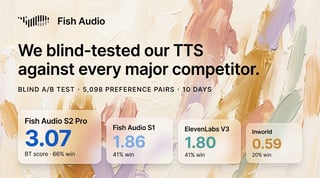
- معدل فوز 61% مقابل الجيل السابق S2 Pro في تقييمات الاستماع المباشرة — راجع مقارنة مزودي TTS العمياء الخاصة بنا للمزيد من التفاصيل.
- ~70ms وقت استلام أول مقطع صوتي (TTFA) للطلب الواحد — بانخفاض من ~100ms في الجيل السابق.
- تحسين الإنتاجية بأكثر من ضعفين تحت ضغط الطلبات المتزامنة العالية.
للاطلاع على الخلفية التقنية الكاملة، راجع ورقتنا البحثية: هنا
تغطية اللغات
يدعم S2.1 Pro 83 لغة، بما في ذلك الإنجليزية، اليابانية، الصينية، الكورية، الإسبانية، العربية، الفرنسية، الألمانية، البرتغالية، الروسية، وعشرات اللغات الأخرى. نفس النموذج يتعامل مع جميع اللغات — لا توجد نقاط نهاية منفصلة، ولا تسعير لكل لغة.
زمن الوصول
يوفر S2.1-Pro حوالي 90ms TTFA (وقت استلام أول مقطع صوتي) على واجهة برمجة التطبيقات القياسية، مما يجعله مناسباً لعملاء الصوت المباشر وأنظمة الحوار التفاعلية. إذا كنت بحاجة إلى تحكم دقيق في نبرة الكلام وأسلوب الإلقاء، فراجع أيضاً قدرات S2 في التحكم الصوتي على مستوى الكلمة.
لماذا يمكن لـ Fish Audio تقديم هذا مجاناً الآن؟

باختصار: أعدنا بناء حزمة الاستدلال (inference stack) من الصفر، وانخفضت التكلفة لكل طلب بشكل ملحوظ لدرجة أننا نستطيع تحملها.
كيرنلات مخصصة لوحدات معالجة الرسومات (Custom GPU Kernels)
قمنا بتطوير fish-scales-ops، وهي مكتبة FP8 GEMM و FlashAttention بمستوى إنتاجي تستهدف معماريات NVIDIA Hopper (H100/H200) و Blackwell (RTX 6000 PRO). في عمليات فك التشفير المهمة لخدمات الذكاء الاصطناعي الصوتي، يتفوق مسار MXFP8 الخاص بنا على مرجع torch.compile-fused cuBLAS بنسبة 2.1–4.3 ضعفاً. لست بحاجة إلى فهم أي من هذا لاستخدام API — ولكنه السبب وراء استدامة المستوى المجاني.
إنتاجية أعلى
على وحدة H200 واحدة مع تكميم FP8، يحافظ النظام على إنتاجية مخرجات تتجاوز 8,000 رمز/ثانية عند 64 طلباً متزامناً. المزيد من الإنتاجية لكل GPU يعني معالجة المزيد من الطلبات لكل دولار، وهذا ما يجعل الوصول المجاني غير المحدود ممكناً اقتصادياً.
ماذا تعني كلمة "مجاني" فعلياً؟
نفضل أن نكون صريحين بشأن القيود بدلاً من إخفائها.
ما تحصل عليه:
- سلسلة النموذج (Model string):
s2.1-pro-free - وصول بحجم طلبات كبير بدون حد أقصى صارم للحروف (يخضع لسياسة الاستخدام العادل)
- نفس نقطة نهاية API الخاصة بالخطط المدفوعة — لا يوجد تكامل منفصل
القيود الحالية:
- المدة:
الوصول المجاني متاح حتى 24 يوليو 2026. الوصول المجاني متاح حتى نهاية يوليو 2026. الوصول المجاني متاح حتى 31 أغسطس 2026.الوصول المجاني متاح حتى 30 نوفمبر 2026 — سنقوم بالإبلاغ عن أي تغييرات مع إشعار مسبق.- تحديث (يونيو 2026): سنقوم بتمديد الفترة المجانية لتشمل شهر يوليو بالكامل. نريد للمطورين أن يحصلوا على شهر كامل وغير منقطع للبناء والتقييم والإطلاق — وليس للعد التنازلي للموعد النهائي.
- تحديث (يوليو 2026): سنقوم بتمديد الوصول المجاني مرة أخرى، حتى 31 أغسطس 2026. إن رؤية ما بناه مطورو Fish Audio باستخدام S2.1 Pro كان أمراً ملهماً حقاً، ونريد منح هذا الزخم مساحة أكبر للنمو.
- لا توجد اتفاقية مستوى خدمة (SLA): لا توجد ضمانات لوقت التشغيل أو سرعة الاستجابة (TTFA)؛ صُمم هذا المستوى للتجريب وبناء النماذج الأولية.
- لا يوجد ضمان لزمن الوصول: أفضل جهد ممكن، وليس تعاقدياً.
- الاحتفاظ بالبيانات: قد تُستخدم الطلبات لتحسين جودة النموذج — راجع سياسة الخصوصية الخاصة بنا.
- الاستخدام التجاري: قد تخضع بعض السيناريوهات التجارية لقيود. يجب على المنتجات التي تحقق أكثر من مليون دولار من الإيرادات السنوية المتكررة (ARR) الاتصال بنا قبل استخدام S2.1 Pro Free. راجع الأسعار وحدود المعدل للحصول على التفاصيل.
إذا كنت بحاجة إلى ضمانات SLA وزمن وصول للإنتاج، تتوفر خطط مدفوعة. هذا المستوى هو المكان المناسب للبناء والتقييم واتخاذ القرار.
كيفية استخدام API المجاني لتحويل النص إلى كلام: دليل البدء السريع لـ S2.1 Pro
احصل على مفتاح API الخاص بك من fish.audio/app/api-keys، ثم قم بإجراء أول استدعاء لك. يقبل Fish API الطلبات المشفرة بصيغة msgpack ويعيد الصوت بالتنسيق الذي تختاره. المرجع الكامل في وثائق API.
JavaScript
import { writeFile } from "fs/promises";

const body = {
  text: "Hello, world!",
  reference_id: "your_model_id",
  format: "mp3",
};

const res = await fetch("https://api.fish.audio/v1/tts", {
  method: "POST",
  headers: {
    Authorization: "Bearer <YOUR_API_KEY>",
    "Content-Type": "application/json",
    model: "s2.1-pro-free",
  },
  body: JSON.stringify(body),
});

if (!res.ok) {
  throw new Error(`TTS request failed: ${res.status} ${await res.text()}`);
}

const buffer = Buffer.from(await res.arrayBuffer());
await writeFile("output.mp3", buffer);
Python
import httpx

body = {
    "text": "Hello, world!",
    "reference_id": "your_model_id",
    "format": "mp3",
}

with httpx.Client() as client:
    res = client.post(
        "https://api.fish.audio/v1/tts",
        headers={
            "Authorization": "Bearer <YOUR_API_KEY>",
            "Content-Type": "application/json",
            "model": "s2.1-pro-free",
        },
        json=body,
    )

res.raise_for_status()

with open("output.mp3", "wb") as f:
    f.write(res.content)
التغيير الوحيد عن أي استدعاء آخر لـ Fish Audio API: قم بتعيين model: "s2.1-pro-free" في الترويسات (headers). هذا كل شيء.
احصل على مفتاح API المجاني الخاص بك ←
S2.1 Pro مقابل ElevenLabs وأفضل واجهات برمجة تطبيقات TTS في عام 2026
تعتمد معلومات المنافسين أدناه على الوثائق وصفحات الأسعار المتاحة للجمهور اعتباراً من يونيو 2026. قد تتغير الأسعار والميزات — يرجى التحقق مباشرة من كل مزود قبل اتخاذ قرار بشأن الإنتاج.

للحصول على تحليل مستقل أعمق، راجع مقارنة مزودي TTS العمياء الخاصة بنا.
الخلاصة: من بين مزودي واجهات برمجة تطبيقات TTS الرئيسيين الذين قمنا بتقييمهم، تقدم Fish Audio حالياً واحداً من أكثر نماذج الوصول المجاني سخاءً — وهو الوحيد الذي يشغل فيه المستوى المجاني نفس النموذج المتطور مثل المستوى المدفوع، دون حد استخدام صارم. المستوى المجاني لـ ElevenLabs هو فعلياً تجربة بـ 10,000 رصيد. أما Gemini TTS من Google فليس لديه مستوى مجاني على الإطلاق.
تبحث عن بديل مجاني لـ ElevenLabs لا يضحي بجودة النموذج؟ S2.1 Pro متاح الآن بدون حد استخدام.
تبحث عن بديل مجاني لـ OpenAI TTS؟ لا توفر OpenAI مستوى مجانياً لخدمة TTS — لذا يعد S2.1 Pro خياراً مقنعاً للتقييم أولاً.
شاهد وثائق API الكاملة وابدأ البناء ←
ما الذي يمكنك بناؤه باستخدامه؟
المستوى المجاني غير مقيد عمداً في حالات الاستخدام. إليك السيناريوهات التي يميل فيها مزيج S2.1 Pro من إنشاء أصوات الذكاء الاصطناعي منخفضة زمن الوصول ودعم تعدد اللغات واستنساخ الصوت إلى إحداث الفرق الأكبر.
عملاء الصوت (Voice Agents)
الذكاء الاصطناعي للمحادثات في الوقت الفعلي يعتمد بشكل كلي على زمن الوصول. مع سرعة استجابة تبلغ حوالي 90ms TTFA للمكالمات القياسية، فإن S2.1 Pro سريع بما يكفي لإجراء حوارات طبيعية متبادلة. ادمجه مع طبقة تحويل الكلام إلى نص وLLM للحصول على خط معالجة صوتي كامل دون فواتير لكل حرف. يمكنك أيضاً دمج S2.1 Pro في سير عمل الوكلاء عبر دعمنا لمهارات الوكيل وMCP.
الكتب الصوتية والسرد الطويل
دعم 83 لغة ونبرة الصوت الطبيعية تجعل S2.1 Pro مناسباً تماماً لإنتاج الكتب الصوتية وتركيب الكلام الطويل. الاستخدام غير المحدود يعني أنه يمكنك معالجة مخطوطات كاملة دون مراقبة عداد الحروف أو شراء أرصدة مسبقاً.
استنساخ الصوت (Voice Cloning)
يدعم S2.1 Pro استنساخ الصوت من صوت مرجعي عبر API — قم بتمرير عينة صوتية مرجعية وسيقوم النموذج بتركيب الكلام بهذا الصوت. قم ببناء تطبيقات صوتية مخصصة، أو ترجم المحتوى محلياً مع الحفاظ على هوية المتحدث، أو أنشئ أصوات شخصيات للألعاب والرسوم المتحركة. استنساخ الصوت متاح في المستوى المجاني، ويخضع لنفس سياسة الاستخدام العادل.
التطبيقات متعددة اللغات
إذا كان تطبيقك يخدم مستخدمين بلغات متعددة، فإن تغطية 83 لغة باستخدام واجهة برمجة تطبيقات صوتية موحدة ومتسقة تعد تبسيطاً كبيراً مقارنة بالبدائل التي تتطلب نقاط نهاية نماذج منفصلة لكل لغة أو تفرض أسعاراً مميزة لتركيب الكلام بغير الإنجليزية.
حوارات الشخصيات في الألعاب (NPC)
تستفيد خطوط معالجة الصوت في الألعاب من الإنتاجية العالية والتكلفة المتوقعة لكل طلب. الاستخدام المجاني غير المحدود يجعل من العملي إنشاء مكتبات حوار كبيرة والتكرار بحرية أثناء التطوير قبل الالتزام بميزانية الإنتاج.
متاح من خلال منظومة شركائنا
يتوفر S2.1 Pro أيضاً من خلال عدد متزايد من منصات الشركاء، بما في ذلك Runware، وRetell، وSierra، وغيرها.
إذا كنت تبني بالفعل على إحدى هذه المنصات، فيمكنك الوصول إلى S2.1 Pro دون تكامل أو إعداد إضافي — فقط استخدم ما لديك بالفعل.
نحن نعمل بنشاط على توسيع شبكة شركائنا. إذا كنت مزود منصة أو بنية تحتية ومهتماً بدمج S2.1 Pro، تواصل مع فريقنا لاستكشاف الإمكانيات.
الاستخدام العادل وما سيأتي لاحقاً
يعمل المستوى المجاني بموجب سياسة الاستخدام العادل. نحتفظ بالحق في تقييد أو تحديد الوصول لأنماط الاستخدام التي تبدو وكأنها إساءة استخدام بدلاً من تطوير — الهدف هو حماية الوصول لمجتمع المطورين بأكمله، وليس إنشاء حدود تعسفية لحالات الاستخدام المشروعة. راجع الأسعار وحدود المعدل للحصول على التفاصيل.
إليك بعض الأمور التي يجب توقعها:
- الوصول المجاني متاح الآن لفترة أولية. سنقدم إشعاراً مسبقاً قبل حدوث أي تغيير.
- الخطط المدفوعة مع ضمانات SLA، والتزامات زمن الوصول، والتراخيص التجارية متاحة لأعباء العمل الإنتاجية.
- الاستثمار في البنية التحتية مستمر — العمل الهندسي الذي جعل هذا المستوى المجاني ممكناً ليس حدثاً لمرة واحدة.
- بنية تحتية مفتوحة المصدر: نخطط لفتح مصدر مكونات البنية التحتية وراء S2.1 Pro — نفس الحزمة التقنية التي تجعل المستوى المجاني مستداماً.
إذا كنت تقيم Fish Audio للنشر في بيئة إنتاجية، فإن المستوى المجاني هو المكان المناسب للبدء. ابنِ شيئاً حقيقياً، وقس ما يهم لتطبيقك، وتواصل معنا عندما تكون مستعداً لمناقشة متطلبات الإنتاج.
لا حاجة لبطاقة ائتمان. لا توجد قائمة انتظار. لا حدود لما يمكنك تجربته.
الأسئلة المتكررة
ما هي واجهة برمجة تطبيقات تحويل النص إلى كلام (TTS API)؟
هل Fish Audio S2.1 Pro مجاني حقاً؟
ما هي أفضل واجهة برمجة تطبيقات TTS مجانية في عام 2026؟
كيف تقارن Fish Audio بـ ElevenLabs؟
هل تدعم Fish Audio استنساخ الصوت؟
هل يمكنني استخدام Fish Audio تجارياً؟
ما هي اللغات التي تدعمها Fish Audio؟