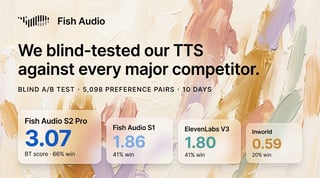
Fish Audio Drama 3: Fish Audio 역사상 가장 감정이 풍부한 TTS 모델


Drama 3는 Fish Audio의 가장 감정이 풍부한 텍스트 음성 변환(TTS) 모델입니다. S2.1 Pro보다 훨씬 더 풍부한 감정을 표현하며, Artificial Analysis의 발음 견고성(Pronunciation Robustness) 벤치마크에서 1위를 차지했습니다.
2026년 10월 13일 | Drama 3를 오늘부터 fish.audio의 TTS, Fish Audio 앱(iOS 및 Android) 및 API에서 만나보실 수 있습니다. 11월 12일까지 API 80% 할인, 신규 크리에이터 플랜 50% 할인이 진행됩니다.
핵심 요약:
- 동일한 디렉션, 더 강력한 연기. S2.1 Pro에 주었던 것과 같은 디렉션을 Drama 3에 입력해 보세요. 실제 같은 눈물 섞인 목소리, 절제된 분노, 그리고 무표정을 뚫고 나오는 웃음소리를 들을 수 있습니다.
- 사용자의 지시를 정확히 따릅니다. 속삭임은 속삭임으로 남고, 웃음은 지정한 위치에서 터지며, 문장 중간이라도 지시한 대로 낭독 톤이 변화합니다.
- 모든 단어를 정확하게. Drama 3는 Artificial Analysis의 독립적인 발음 견고성 벤치마크에서 1위를 기록했습니다. 어려운 단어, 숫자 및 코드를 93.2%의 정확도로 읽어내며, S2.1 Pro의 88.1%를 앞섰습니다.
- 공개 가중치(Open Weights). Hugging Face에서 Drama 3를 직접 실행해 보세요. 귀하와 계열사의 연간 매출이 미화 50만 달러 미만인 경우 상업적 이용이 무료입니다 (Fish Audio Community License v1.0).
출시 영상에서 Uncle Roger는 본인의 동의하에 제작 및 사용된 AI 보이스 클론을 직접 디렉팅합니다.
이제 여러분의 차례입니다. Uncle Roger의 목소리가 Fish Audio에 준비되어 있으니, 직접 디렉팅해 보세요.
동일한 디렉션, 훨씬 깊은 감정
디렉션은 배우에게 말하듯 대괄호 안에 작성합니다. 여기 S2.1 Pro와 Drama 3에서 동일한 목소리와 디렉션으로 생성한 한 문장을 비교해 보세요.
S2.1 Pro
Drama 3
[barely holding it together, forcing a smile] I'm fine. [shaky breath] Really. [small laugh] [whispering] Go on without me.
목소리가 떨리는 와중에도 억지 미소를 유지하는 소리, 그리고 숨소리, 웃음, 속삭임이 정확히 텍스트에 쓴 위치에서 구현되는 것을 들어보세요.
눈물, 분노, 웃음
이들은 음성 모델이 가장 평면적으로 표현하기 쉬운 감정들입니다. 각 문장에서 두 번째 디렉션에 집중해 보세요. 목소리가 떨리거나, 조용해지거나, 웃음이 터져 나오는 지점입니다.
울먹임.
[choked up, crying quietly] I left his jacket by the door. [voice breaking] I keep thinking he'll walk in and ask for it.
분노를 억누름.
[through gritted teeth, keeping his voice down] I asked you to do one thing tonight. [slow, dangerously quiet] Just one.
참지 못하고 터진 웃음.
[straight-faced, trying very hard to stay serious] No, I love it, it really suits you. [cracking up despite herself] I'm sorry, it's just a very brave haircut.
사용자의 디렉션을 완벽히 따릅니다
분위기가 바뀌는 지점에 새로운 디렉션을 추가하면, 낭독 톤이 즉시 변경됩니다.
[breathless, speaking fast] Just turn off the lights. Stay away from the windows. [voice drops to a terrified whisper] And whatever you hear out there… [slow, deadly serious] <emphasis>do not open that door.</emphasis>
마지막 단어들은 <emphasis>…</emphasis> 쌍 태그 안에 있습니다. 이 태그는 시작과 종료 태그 사이의 단어들에만 디렉션을 적용합니다. TTS 도구에서 단어를 선택하고 태그 메뉴에서 태그를 골라 적용할 수 있습니다.
Drama 3는 83개 언어를 구사합니다. 디렉션은 여러분이 생각하는 어떤 언어로든 작성할 수 있으며, 낭독할 문장의 언어와 일치하지 않아도 됩니다.
중국어로 작성된 디렉션
[像是在强忍着眼泪,却努力笑着] I'm fine. Really. Go on without me.
스페인어로 작성된 디렉션
[conteniendo las lágrimas, pero sonriendo] I'm fine. Really. Go on without me.
일본어로 작성된 디렉션
[涙をこらえながら、無理に笑って] I'm fine. Really. Go on without me.
모든 단어를 정확하게
감정이 풍부하더라도 단어를 제대로 전달하지 못하면 의미가 없습니다. Artificial Analysis는 이를 독립적으로 테스트합니다. '발음 견고성' 벤치마크는 영어 문장에 어려운 단어(숫자, 코드, 브랜드 이름, 문맥에 따라 읽는 법이 달라지는 단어)를 배치하고, 사람이 각 단어를 제대로 읽었는지 확인합니다. Drama 3는 93.2%의 정확도로 리더보드 1위를 차지했으며, S2.1 Pro는 88.1%를 기록했습니다.

| 읽기 항목 | Drama 3 | Fish Audio S2.1 Pro |
|---|---|---|
| 브랜드, 장소, 기술 용어 이름 | 95.9% | 87.3% |
| 문맥에 따라 읽는 법이 변하는 단어 | 95.3% | 86.1% |
| 약어: 숫자, 날짜, 단위, 표기법 | 93.6% | 92.7% |
| 정확한 시퀀스: 코드, 경로, 이메일 | 86.3% | 79.4% |
| 전체 평균 | 93.2% | 88.1% |
S2.1 Pro 대비 가장 큰 발전은 브랜드/지명/기술 용어 및 문맥 의존적 단어에서 나타났습니다. 파일 경로 및 이메일 주소와 같은 정확한 시퀀스도 79.4%에서 86.3%로 개선되었습니다.
Drama 3가 디렉팅을 배운 방법
자사의 S2를 포함한 기존 음성 모델들은 보통 전사가 쉽고 참조 클립과 비슷하게 들리는지에 대한 보상(Reward)으로 튜닝되는데, 이러한 방식은 웃음이나 속삭임을 감점 요인으로 처리하곤 합니다. Drama 3는 대신 '사람들이 어떤 결과물을 선호했는지'에 대한 모델 하나를 보상으로 사용하여 튜닝되었습니다. 이 모델은 대본과 음성을 모두 고려하므로 정확성과 유사성도 여전히 중요하게 다뤄지지만, 사용자가 요청한 웃음소리를 감점하지 않습니다. 자세한 내용은 기술 리포트에서 확인하실 수 있습니다.
Drama 3의 용도
Drama 3는 한 번 렌더링하여 소장하는 완성된 대본 작업에서 가장 뛰어난 성능을 발휘합니다.
- 오디오북 및 내레이션. Drama 3는 한 챕터를 일관되게 읽으면서도, 아픔이 느껴져야 하는 한 문장에서 목소리가 떨리게 하거나 "제17장"과 같은 숫자를 정확히 읽어낼 수 있습니다.
- 오디오 드라마 및 픽션 팟캐스트. 위의 문 사례처럼 한 문장 안에서 공포에서 속삭임, 위협으로 감정을 전환할 수 있습니다.
- 게임 및 애니메이션. 모든 대사마다 개별적인 디렉팅이 가능합니다. 이를 악물고 참는 분노, 억제할 수 없는 웃음 등을 구현해 보세요.
- 숏폼 비디오. 스토리 비디오나 코미디 스킷에서 눈물이나 유머 포인트가 필요한 순간에 맞춰 웹이나 Fish Audio 앱에서 바로 생성할 수 있습니다.
"음성 AI는 이제 음성 생성 능력이 매우 뛰어납니다. 다음 단계는 연기를 디렉팅하는 것입니다. Drama 3는 현재까지 저희가 만든 모델 중 가장 감정적이고 제어 가능한 모델입니다. 크리에이터를 감독의 의자에 앉혀 드립니다. 평이한 언어로 원하는 바를 설명하고, 들어보고, 어색한 부분만 수정하세요. 이는 오디오북이나 다국어 더빙과 같은 장편 프로젝트에서 특히 중요합니다. 단어 하나가 틀렸다고 챕터 전체를 다시 생성할 필요가 없기 때문입니다."
— Rissa Cao, Fish Audio 공동 창립자 겸 CEO
Drama 3 직접 실행하기
S2와 마찬가지로 Drama 3는 공개 가중치로 출시되어 직접 실행할 수 있습니다. 새로운 라이선스인 Fish Audio Community License v1.0이 적용됩니다. 연구 및 비상업적 용도는 무료이며, 귀하와 계열사의 연간 매출이 미화 50만 달러 미만인 경우 상업적 이용도 무료입니다. 이를 초과하거나 Drama 3를 타인에게 TTS, 보이스 클로닝, 추론 서비스 또는 API로 제공하려면 Fish Audio(business@fish.audio)의 라이선스가 필요합니다. 또한 라이선스는 당사자의 동의 없는 실존 인물의 목소리 클로닝을 금지합니다. S2는 기존의 Fish Audio Research License를 유지합니다. 가중치와 전체 라이선스는 Hugging Face에, 코드는 GitHub에 공개되어 있습니다.
대부분의 상업용 음성 모델은 구조를 밝히지 않지만, Drama 3의 작동 원리는 다음과 같습니다. Drama 3는 매 단계마다 자신의 일부만 사용하는 하나의 거대 모델이며, 긴 대본과 여러 음성 클립에 적합한 메모리를 갖추고 있습니다. 새로운 오디오 디코더인 codebook-MTP 디코더는 모든 소리의 미세한 질감을 채우면서 참조 음성 클립을 포함한 이전의 모든 내용을 다시 검토합니다. 그리고 앞서 언급했듯이, 사람들이 선호하는 결과물 모델을 통해 튜닝되었습니다.
개발자 및 연구자용 정보

기술 리포트의 그림 2. 백본은 시스템 프롬프트, 대상 텍스트, 그리고 자체 오디오 프레임을 읽으며, 각 프레임은 코드 0과 1의 융합 임베딩(fused embedding)으로 입력됩니다. codebook-MTP 디코더는 백본의 히든 스테이트 위에서 모든 포지션을 실행합니다. 4개의 공유 레이어는 해당 상태, 예측된 코드 0, 그리고 백본을 거치지 않은 입력 프레임의 코드 29를 가져오며, MTP 레이어 19는 나머지 코드들을 하나씩 예측합니다. 코드는 다음 토큰이 오디오 프레임인 곳마다 예측되며, 모든 레이어는 시간에 따라 인과적(causally)으로 어텐션을 수행합니다. 오디오 토크나이저 디코더는 10개의 코드를 파형으로 변환합니다.
- 백본. 35B 파라미터 Mixture-of-Experts, 토큰당 약 3B 활성화(256개 라우팅 전문가 중 8개 + 1개 공유 전문가), Qwen3.5-35B-A3B 언어 모델에서 초기화.
- 하이브리드 어텐션. 3개의 Gated DeltaNet 레이어와 1개의 gated full-attention 레이어로 구성된 블록 40개. DeltaNet 레이어는 고정 크기 상태에 히스토리를 저장하며, 4개 레이어 중 하나만 KV 캐시를 유지합니다.
- Codebook-MTP 디코더. S2의 프레임별 Fast AR을 대체합니다. 4개의 공유 레이어가 9개의 전체 너비 레이어(코드북 1~9당 하나씩)에 입력되며, 모든 레이어는 참조 오디오의 세부 코드를 포함한 전체 시퀀스에 대해 인과적 어텐션을 수행합니다.
- 부분 코드북 융합. 노출 편향(exposure bias)을 제한하기 위해 코드북 0과 1만 백본으로 피드백됩니다(S2는 10개 모두 피드백). 코드 2~9는 디코더로 직접 전달됩니다.
- 토크나이저. S2와 동일하게 Descript Audio Codec 기반으로 제작: 44.1 kHz, 10개 코드북(1개 시맨틱, 9개 레지듀얼), 초당 약 21.5 프레임, 완전 인과적.
- 학습. 3단계 사전 학습, 인스트럭션 파인튜닝, 이후 RL. 모든 태스크는 동일한 ChatML 스타일 포맷의 대화 형식으로 작성되었습니다.
- RL. 학습된 인간 선호도 보상 모델 1개 사용, 규칙 기반 보상 없음. KL 페널티 없는 GRPO, 단계당 1,536개 프롬프트 × 8개 결과물.
- 추론. 단일 H200에서 초당 271 프레임을 디코딩하며(S2는 177 프레임), 파라미터가 7배 이상 많음에도 불구하고 더 빠릅니다. SGLang-Omni를 통해 추론이 가능합니다.
자세한 내용은 기술 리포트를 참고하세요.
API에서의 Drama 3
이 포스트의 모든 스크립트는 API에서 그대로 작동합니다. model 헤더를 drama-3로 설정하고, 태그를 포함한 스크립트를 text에 넣으세요.
curl https://api.fish.audio/v1/tts \
  -H "Authorization: Bearer <your-api-key>" \
  -H "Content-Type: application/json" \
  -H "model: drama-3" \
  -d '{
    "text": "[breathless, speaking fast] Just turn off the lights. Stay away from the windows. [voice drops to a terrified whisper] And whatever you hear out there… [slow, deadly serious] <emphasis>do not open that door.</emphasis>",
    "reference_id": "536d3a5e000945adb7038665781a4aca",
    "format": "mp3"
  }' \
  -o door.mp3
S2.1 Pro와 동일한 엔드포인트를 사용하므로, 기존 통합 환경에서 헤더 하나만 바꾸면 즉시 전환할 수 있습니다. 태그와 파라미터는 Drama 3 문서에서 확인하세요.
향후 계획
두 가지 편집 도구가 현재 소규모 초대 전용 테스트 중이며, 편집 API도 곧 출시될 예정입니다. 미리 살펴보세요.
인터랙티브 편집
결과물을 듣고 Drama 3에게 수정 사항을 말하면, 이전 결과물을 기억하며 다시 연기합니다. 디렉션은 상대적("방금보다 더 부드럽게")이거나 완전히 새로운 내용일 수 있습니다.
문장: The results just came in. We didn't make it.
테이크 1: 무겁고 기운 없는 슬픔
테이크 2: "이전보다 더 부드럽고 따뜻하게"
테이크 3: "이전보다 더 즐겁게, 슬픔은 빼고"
오디오 인페인팅 (Audio Inpainting)
마음에 드는 결과물이 나왔는데 대본이 바뀌었나요? 단어를 표시하고 새 단어를 입력하면 Drama 3가 앞뒤 목소리, 분위기, 속도에 맞춰 해당 단어만 다시 생성합니다. 나머지는 이미 승인된 결과물을 유지합니다. 위에서 들었던 울먹이는 문장에서 단어 하나를 수정한 결과입니다.
I left his jacket scarf by the door. I keep thinking he'll walk in and ask for it.

원본 테이크
편집 후 ("scarf" 부분만 신규 생성)
출시 기념 혜택
개발자용: 10월 13일부터 11월 12일까지, Drama 3 API를 100만 자당 50 대비 80% 할인).
크리에이터용: Drama 3는 S2.1 Pro와 동일한 크레딧이 소모됩니다. 11월 12일까지 신규 Plus, Pro 또는 Max 플랜 결제 시 50% 할인 혜택을 드립니다 (월간 플랜 첫 달 또는 연간 플랜 첫 해). 출시 포스트에 첫 48시간 이내에 댓글을 남겨주시면 Fish Audio Plus 1개월 무료 이용권을 드립니다.
결과물마다 차이가 있을 수 있으니, 몇 번 렌더링해 보고 가장 잘 된 것을 선택하세요. 만약 디렉션이 제대로 반영되지 않는다면 Discord에 스크립트를 공유해 주세요. 여러분의 피드백이 큰 도움이 됩니다.
대본을 준비하세요. 여러분의 디렉팅을 보여주세요.
자주 묻는 질문
Fish Audio Drama 3란 무엇인가요?
Drama 3는 어떤 언어를 지원하나요?
Drama 3가 S2.1 Pro보다 나은 점은 무엇인가요?
문장 전체 또는 일부 단어만 디렉팅하려면 어떻게 하나요?
인터랙티브 편집이나 오디오 인페인팅을 지금 사용할 수 있나요?
API를 통해 Drama 3를 어떻게 사용하나요?
Drama 3는 오픈 소스인가요? 상업적으로 이용할 수 있나요?
Drama 3 이용 가격은 얼마인가요?
Rissa is the CEO and co-founder of Fish Audio, pushing breakthroughs in AI voice technology. Find her latest work at @rissa_cao.
Rissa Cao의 더 많은 글 보기
Jiahua Liu is the CTO and co-founder of Fish Audio, pushing breakthroughs in AI voice technology.
Jiahua Liu의 더 많은 글 보기