Fish Audio S2.1 Pro: Kostenlose Text-to-Speech-API für Entwickler


Kurzzusammenfassung:
S2.1 Pro, das fortschrittlichste Sprachmodell von Fish Audio, ist jetzt als kostenlose Text-to-Speech-API verfügbar.
83 Sprachen, unbegrenzte Nutzung unter der Fair-Use-Richtlinie.
Modell-String: s2.1-pro-free — fügen Sie ihn einfach in Ihre bestehenden Fish API-Aufrufe ein.
S2.1 Pro kostenlos testen — erstes Audio in 5 Minuten →
Juni 2026 | Das S2.1 Pro-Modell von Fish Audio ist jetzt als kostenlose Text-to-Speech-API mit unbegrenztem Zugriff unter Fair-Use-Bedingungen verfügbar.
Warum hochwertige KI-Stimmen bisher immer teuer waren
Wenn Sie bereits Zeit damit verbracht haben, Text-to-Speech-APIs zu evaluieren, kennen Sie das Muster: Die Modelle, die wirklich gut klingen, kosten Geld.
Der kostenlose Tarif von ElevenLabs bietet Ihnen 10.000 Credits pro Monat (ungefähr 6 bis 10 Minuten), bevor die Bezahlschranke greift. OpenAI TTS ist ein Pay-per-Use-Modell ohne kostenlose Stufe. Die neuesten Gemini TTS-Modelle von Google — ihre fortschrittlichsten — bieten keinerlei kostenlose Nutzung: Sie zahlen ab dem ersten Token. Das Muster ist branchenweit konsistent: State-of-the-Art-Sprachqualität war bisher ein kostenpflichtiges Feature.
Dies stellt Entwickler vor ein echtes Problem. Der Markt für KI-Sprachgeneratoren wächst jährlich um fast 20 % — aber die Werkzeuge zum Erstellen sprachgestützter Produkte blieben hinter einer Paywall. Mit 10.000 Credits lässt sich ein Modell nicht angemessen evaluieren. Man kann keinen Sprachagenten prototypisieren, keine Hörbuch-Pipeline testen oder mit Voice Cloning experimentieren, ohne entweder vorab ein Budget bereitzustellen oder Wochen damit zu verbringen, sich mit Open-Source-Alternativen herumzuschlagen, die eine eigene GPU-Infrastruktur erfordern.
Fish Audio ändert das heute.
Was ist S2.1 Pro?

S2.1 Pro ist das aktuelle State-of-the-Art-Sprachmodell von Fish Audio — das beste Modell, das wir haben, steht nun jedem Entwickler kostenlos über die API zur Verfügung. Es ist ein neuronales Sprachsynthesemodell, das für die KI-Sprachgenerierung in Produktionsqualität entwickelt wurde und besondere Stärken in den Bereichen Streaming mit niedriger Latenz, mehrsprachiges TTS und Voice Cloning aufweist. Es baut auf der Grundlage von S2 auf, das wir Anfang des Jahres als Open-Weights-Modell veröffentlicht haben.
Leistung
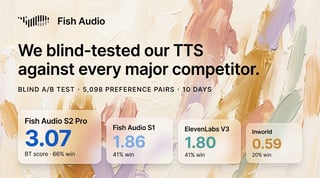
- 61 % Gewinnrate gegenüber der vorherigen Generation S2 Pro in Head-to-Head-Hörvergleichen — siehe unseren Blindvergleich der TTS-Anbieter für mehr Kontext.
- ~70ms Time-to-First-Audio (TTFA) bei einer Einzelanfrage — eine Reduzierung von ~100ms in der Vorgängergeneration.
- Verbesserung des Durchsatzes um mehr als das Zweifache bei hoher gleichzeitiger Auslastung.
Den vollständigen technischen Hintergrund finden Sie in unserem Paper: Hier
Sprachabdeckung
S2.1 Pro unterstützt 83 Sprachen, darunter Englisch, Japanisch, Chinesisch, Koreanisch, Spanisch, Arabisch, Französisch, Deutsch, Portugiesisch, Russisch und Dutzende weitere. Dasselbe Modell verarbeitet alle Sprachen — keine separaten Endpunkte, keine Preisgestaltung pro Sprache.
Latenz
S2.1-Pro liefert eine TTFA (Time to First Audio) von ca. 90ms über die Standard-API, was es für Live-Sprachagenten und Dialogsysteme mit Sprecherwechsel tauglich macht. Wenn Sie eine fein abgestimmte Kontrolle über Prosodie und Vortrag benötigen, siehe auch S2's Funktionen zur Sprachsteuerung auf Wortebene.
Warum Fish Audio dies jetzt kostenlos anbieten kann

Die Kurzfassung: Wir haben den Inferenz-Stack von Grund auf neu aufgebaut, und die Kosten pro Anfrage sind so deutlich gesunken, dass wir sie auffangen können.
Benutzerdefinierte GPU-Kernel
Wir haben fish-scales-ops entwickelt, eine produktionsreife FP8 GEMM- und FlashAttention-Bibliothek für NVIDIA Hopper (H100/H200) und Blackwell (RTX 6000 PRO) Architekturen. Bei den für das Voice-AI-Serving relevanten Decode-Shapes übertrifft unser MXFP8-Pfad die torch.compile-fused cuBLAS-Referenz um das 2,1- bis 4,3-fache. Sie müssen nichts davon verstehen, um die API zu nutzen — aber es ist der Grund, warum die kostenlose Stufe nachhaltig ist.
Höherer Durchsatz
Auf einer einzelnen H200 mit FP8-Quantisierung hält das System bei 64 gleichzeitigen Anfragen einen Output-Durchsatz von über 8.000 Token/Sekunde aufrecht. Mehr Durchsatz pro GPU bedeutet mehr verarbeitete Anfragen pro Dollar, was den unbegrenzten kostenlosen Zugang wirtschaftlich tragfähig macht.
Was „kostenlos“ wirklich bedeutet
Wir sind lieber ehrlich bezüglich der Einschränkungen, anstatt sie zu verstecken.
Was Sie erhalten:
- Modell-String:
s2.1-pro-free - Zugriff für hohe Volumina ohne harte Zeichenbegrenzung (vorbehaltlich der Fair-Use-Richtlinie)
- Derselbe API-Endpunkt wie bei kostenpflichtigen Tarifen — keine separate Integration nötig
Aktuelle Einschränkungen:
- Dauer:
Kostenloser Zugang ist verfügbar bis zum 24. Juli 2026. Kostenloser Zugang ist verfügbar bis Ende Juli 2026. Kostenloser Zugang ist verfügbar bis zum 31. August 2026.Kostenloser Zugang ist bis zum 30. November 2026 verfügbar — wir werden alle Änderungen mit Vorankündigung kommunizieren.- Update (Juni 2026): Wir verlängern das kostenlose Fenster auf den gesamten Juli. Wir möchten, dass Entwickler einen vollen, ununterbrochenen Monat Zeit haben, um zu bauen, zu evaluieren und zu veröffentlichen — ohne einen Countdown im Nacken.
- Update (Juli 2026): Wir verlängern den kostenlosen Zugang noch einmal bis zum 31. August 2026. Zu sehen, was unsere Fish-Entwickler mit S2.1 Pro gebaut haben, war wirklich herzerwärmend, und wir möchten diesem Schwung noch mehr Raum geben.
- Kein SLA: Keine Garantien für Uptime oder TTFA; entwickelt für Experimente und Prototyping.
- Keine Latenzgarantie: Best-Effort-Prinzip, nicht vertraglich zugesichert.
- Datenspeicherung: Anfragen können zur Verbesserung der Modellqualität verwendet werden — siehe unsere Datenschutzrichtlinie.
- Gewerbliche Nutzung: Für bestimmte kommerzielle Szenarien können Einschränkungen gelten. Produkte, die mehr als 1 Mio. $ ARR generieren, sollten uns kontaktieren, bevor sie S2.1 Pro Free nutzen. Details finden Sie unter Preise & Ratenbegrenzungen.
Wenn Sie Produktions-SLA und Latenzgarantien benötigen, sind kostenpflichtige Tarife verfügbar. Diese Stufe ist der richtige Ort, um aufzubauen, zu evaluieren und Entscheidungen zu treffen.
So nutzen Sie die kostenlose Text-to-Speech-API: S2.1 Pro Quickstart
Holen Sie sich Ihren API-Key unter fish.audio/app/api-keys und tätigen Sie Ihren ersten Aufruf. Die Fish API akzeptiert msgpack-kodierte Anfragen und gibt Audio im gewählten Format zurück. Die vollständige Referenz finden Sie in der API-Dokumentation.
JavaScript
import { writeFile } from "fs/promises";

const body = {
  text: "Hello, world!",
  reference_id: "your_model_id",
  format: "mp3",
};

const res = await fetch("https://api.fish.audio/v1/tts", {
  method: "POST",
  headers: {
    Authorization: "Bearer <YOUR_API_KEY>",
    "Content-Type": "application/json",
    model: "s2.1-pro-free",
  },
  body: JSON.stringify(body),
});

if (!res.ok) {
  throw new Error(`TTS request failed: ${res.status} ${await res.text()}`);
}

const buffer = Buffer.from(await res.arrayBuffer());
await writeFile("output.mp3", buffer);
Python
import httpx

body = {
    "text": "Hello, world!",
    "reference_id": "your_model_id",
    "format": "mp3",
}

with httpx.Client() as client:
    res = client.post(
        "https://api.fish.audio/v1/tts",
        headers={
            "Authorization": "Bearer <YOUR_API_KEY>",
            "Content-Type": "application/json",
            "model": "s2.1-pro-free",
        },
        json=body,
    )

res.raise_for_status()

with open("output.mp3", "wb") as f:
    f.write(res.content)
Die einzige Änderung gegenüber jedem anderen Fish Audio API-Aufruf: Setzen Sie model: "s2.1-pro-free" in den Headern. Das ist alles.
Holen Sie sich Ihren kostenlosen API-Key →
S2.1 Pro vs. ElevenLabs und die besten TTS-APIs im Jahr 2026
Die unten stehenden Informationen zu Wettbewerbern basieren auf öffentlich zugänglichen Dokumentationen und Preisseiten Stand Juni 2026. Preise und Funktionen können sich ändern — bitte prüfen Sie diese direkt beim jeweiligen Anbieter, bevor Sie eine Produktionsentscheidung treffen.

Für eine tiefergehende unabhängige Analyse siehe unseren Blindvergleich der TTS-Anbieter.
Fazit: Unter den großen von uns evaluierten TTS-API-Anbietern bietet Fish Audio derzeit eines der großzügigsten kostenlosen Zugangsmodelle — das einzige, bei dem die kostenlose Stufe dasselbe State-of-the-Art-Modell wie die kostenpflichtige Stufe nutzt, ohne harte Nutzungsobergrenze. Der kostenlose Tarif von ElevenLabs ist faktisch eine Testversion mit 10.000 Credits. Das fortschrittlichste TTS von Google (Gemini TTS) hat überhaupt keine kostenlose Stufe.
Suchen Sie nach einer kostenlosen ElevenLabs-Alternative, die keine Kompromisse bei der Modellqualität eingeht? S2.1 Pro ist ab sofort ohne Nutzungsobergrenze verfügbar.
Suchen Sie nach einer kostenlosen OpenAI TTS-Alternative? Das TTS-Angebot von OpenAI hat keine kostenlose Stufe — S2.1 Pro ist eine überzeugende Option für die erste Evaluierung.
Vollständige API-Dokumentation ansehen und mit dem Bauen beginnen →
Was Sie damit bauen können
Die kostenlose Stufe ist bewusst nicht auf bestimmte Anwendungsfälle beschränkt. Hier sind Szenarien, in denen die Kombination aus latenzarmer KI-Sprachgenerierung, mehrsprachiger Unterstützung und Voice Cloning von S2.1 Pro meist den größten Unterschied macht.
Sprachagenten
Konversations-KI in Echtzeit steht und fällt mit der Latenz. Mit einer TTFA von ca. 90ms bei Standardanrufen ist S2.1 Pro schnell genug für einen natürlichen Dialog mit Sprecherwechsel. Kombinieren Sie es mit einer Speech-to-Text-Ebene und einem LLM für eine vollständige Sprach-Pipeline ohne Abrechnung pro Zeichen. Sie können S2.1 Pro auch über unseren Support für MCP und Agent Skills in Agenten-Workflows integrieren.
Hörbücher und lange Erzählungen
Die Unterstützung von 83 Sprachen und eine natürliche Prosodie machen S2.1 Pro ideal für die Hörbuchproduktion und lange Sprachsynthese. Unbegrenzte Nutzung bedeutet, dass Sie vollständige Manuskripte verarbeiten können, ohne auf einen Zeichenzähler zu achten oder vorab Credits kaufen zu müssen.
Voice Cloning
S2.1 Pro unterstützt Voice Cloning aus Referenzaudio via API — übergeben Sie ein Referenzaudio-Sample, und das Modell synthetisiert Sprache in dieser Stimme. Erstellen Sie personalisierte Sprachanwendungen, lokalisieren Sie Inhalte mit konsistenter Sprecheridentität oder generieren Sie Charakterstimmen für Spiele und Animationen. Voice Cloning ist in der kostenlosen Stufe verfügbar, unterliegt jedoch derselben Fair-Use-Richtlinie.
Mehrsprachige Anwendungen
Wenn Ihre Anwendung Nutzer in mehreren Sprachen bedient, ist eine Abdeckung von 83 Sprachen mit einer einzigen konsistenten KI-Sprach-API eine erhebliche Vereinfachung gegenüber Alternativen, die separate Modell-Endpunkte pro Sprache erfordern oder Premium-Preise für nicht-englische Sprachsynthese verlangen.
NPC-Dialoge in Spielen
Audio-Pipelines in Spielen profitieren von hohem Durchsatz und vorhersehbaren Kosten pro Anfrage. Die unbegrenzte kostenlose Nutzung macht es praktikabel, große Dialogbibliotheken zu erstellen und während der Entwicklung frei zu iterieren, bevor man sich auf ein Produktionsbudget festlegt.
Verfügbar über unser Partner-Ökosystem
S2.1 Pro ist auch über eine wachsende Anzahl von Partnerplattformen verfügbar, darunter Runware, Retell, Sierra und andere.
Wenn Sie bereits auf einer dieser Plattformen entwickeln, ist S2.1 Pro ohne zusätzliche Integration oder Einrichtung zugänglich — nutzen Sie einfach das, was Sie bereits haben.
Wir erweitern das Partnernetzwerk aktiv. Wenn Sie ein Plattform- oder Infrastrukturanbieter sind und an einer Integration von S2.1 Pro interessiert sind, kontaktieren Sie unser Team, um die Möglichkeiten zu besprechen.
Fair Use & Ausblick
Die kostenlose Stufe unterliegt einer Fair-Use-Richtlinie. Wir behalten uns das Recht vor, den Zugriff bei Nutzungsmustern, die eher nach Missbrauch als nach Entwicklung aussehen, zu drosseln oder zu begrenzen — das Ziel ist es, den Zugang für die gesamte Entwickler-Community zu schützen und keine willkürlichen Grenzen für legitime Anwendungsfälle zu schaffen. Details finden Sie unter Preise & Ratenbegrenzungen.
Einige Dinge, die Sie erwarten können:
- Der kostenlose Zugang ist ab sofort für einen ersten Zeitraum verfügbar. Wir werden Änderungen rechtzeitig ankündigen.
- Kostenpflichtige Tarife mit SLA-Garantien, Latenzzusagen und kommerzieller Lizenzierung sind für Produktions-Workloads verfügbar.
- Die Investitionen in die Infrastruktur gehen weiter — die technische Arbeit, die diese kostenlose Stufe ermöglicht hat, ist kein einmaliges Ereignis.
- Open-Source-Infrastruktur: Wir planen, die Infrastrukturkomponenten hinter S2.1 Pro als Open Source bereitzustellen — denselben Stack, der die kostenlose Stufe nachhaltig macht.
Wenn Sie Fish Audio für einen Produktionseinsatz evaluieren, ist die kostenlose Stufe der richtige Startpunkt. Bauen Sie etwas Reales, messen Sie, was für Ihre Anwendung wichtig ist, und kontaktieren Sie uns, wenn Sie bereit sind, über Produktionsanforderungen zu sprechen.
Keine Kreditkarte. Keine Warteliste. Keine Grenzen für Ihre Tests.
Häufig Gestellte Fragen
Was ist eine Text-to-Speech-API?
Ist Fish Audio S2.1 Pro wirklich kostenlos?
Was ist die beste kostenlose TTS-API im Jahr 2026?
Wie schneidet Fish Audio im Vergleich zu ElevenLabs ab?
Unterstützt Fish Audio Voice Cloning?
Kann ich Fish Audio kommerziell nutzen?
Welche Sprachen unterstützt Fish Audio?